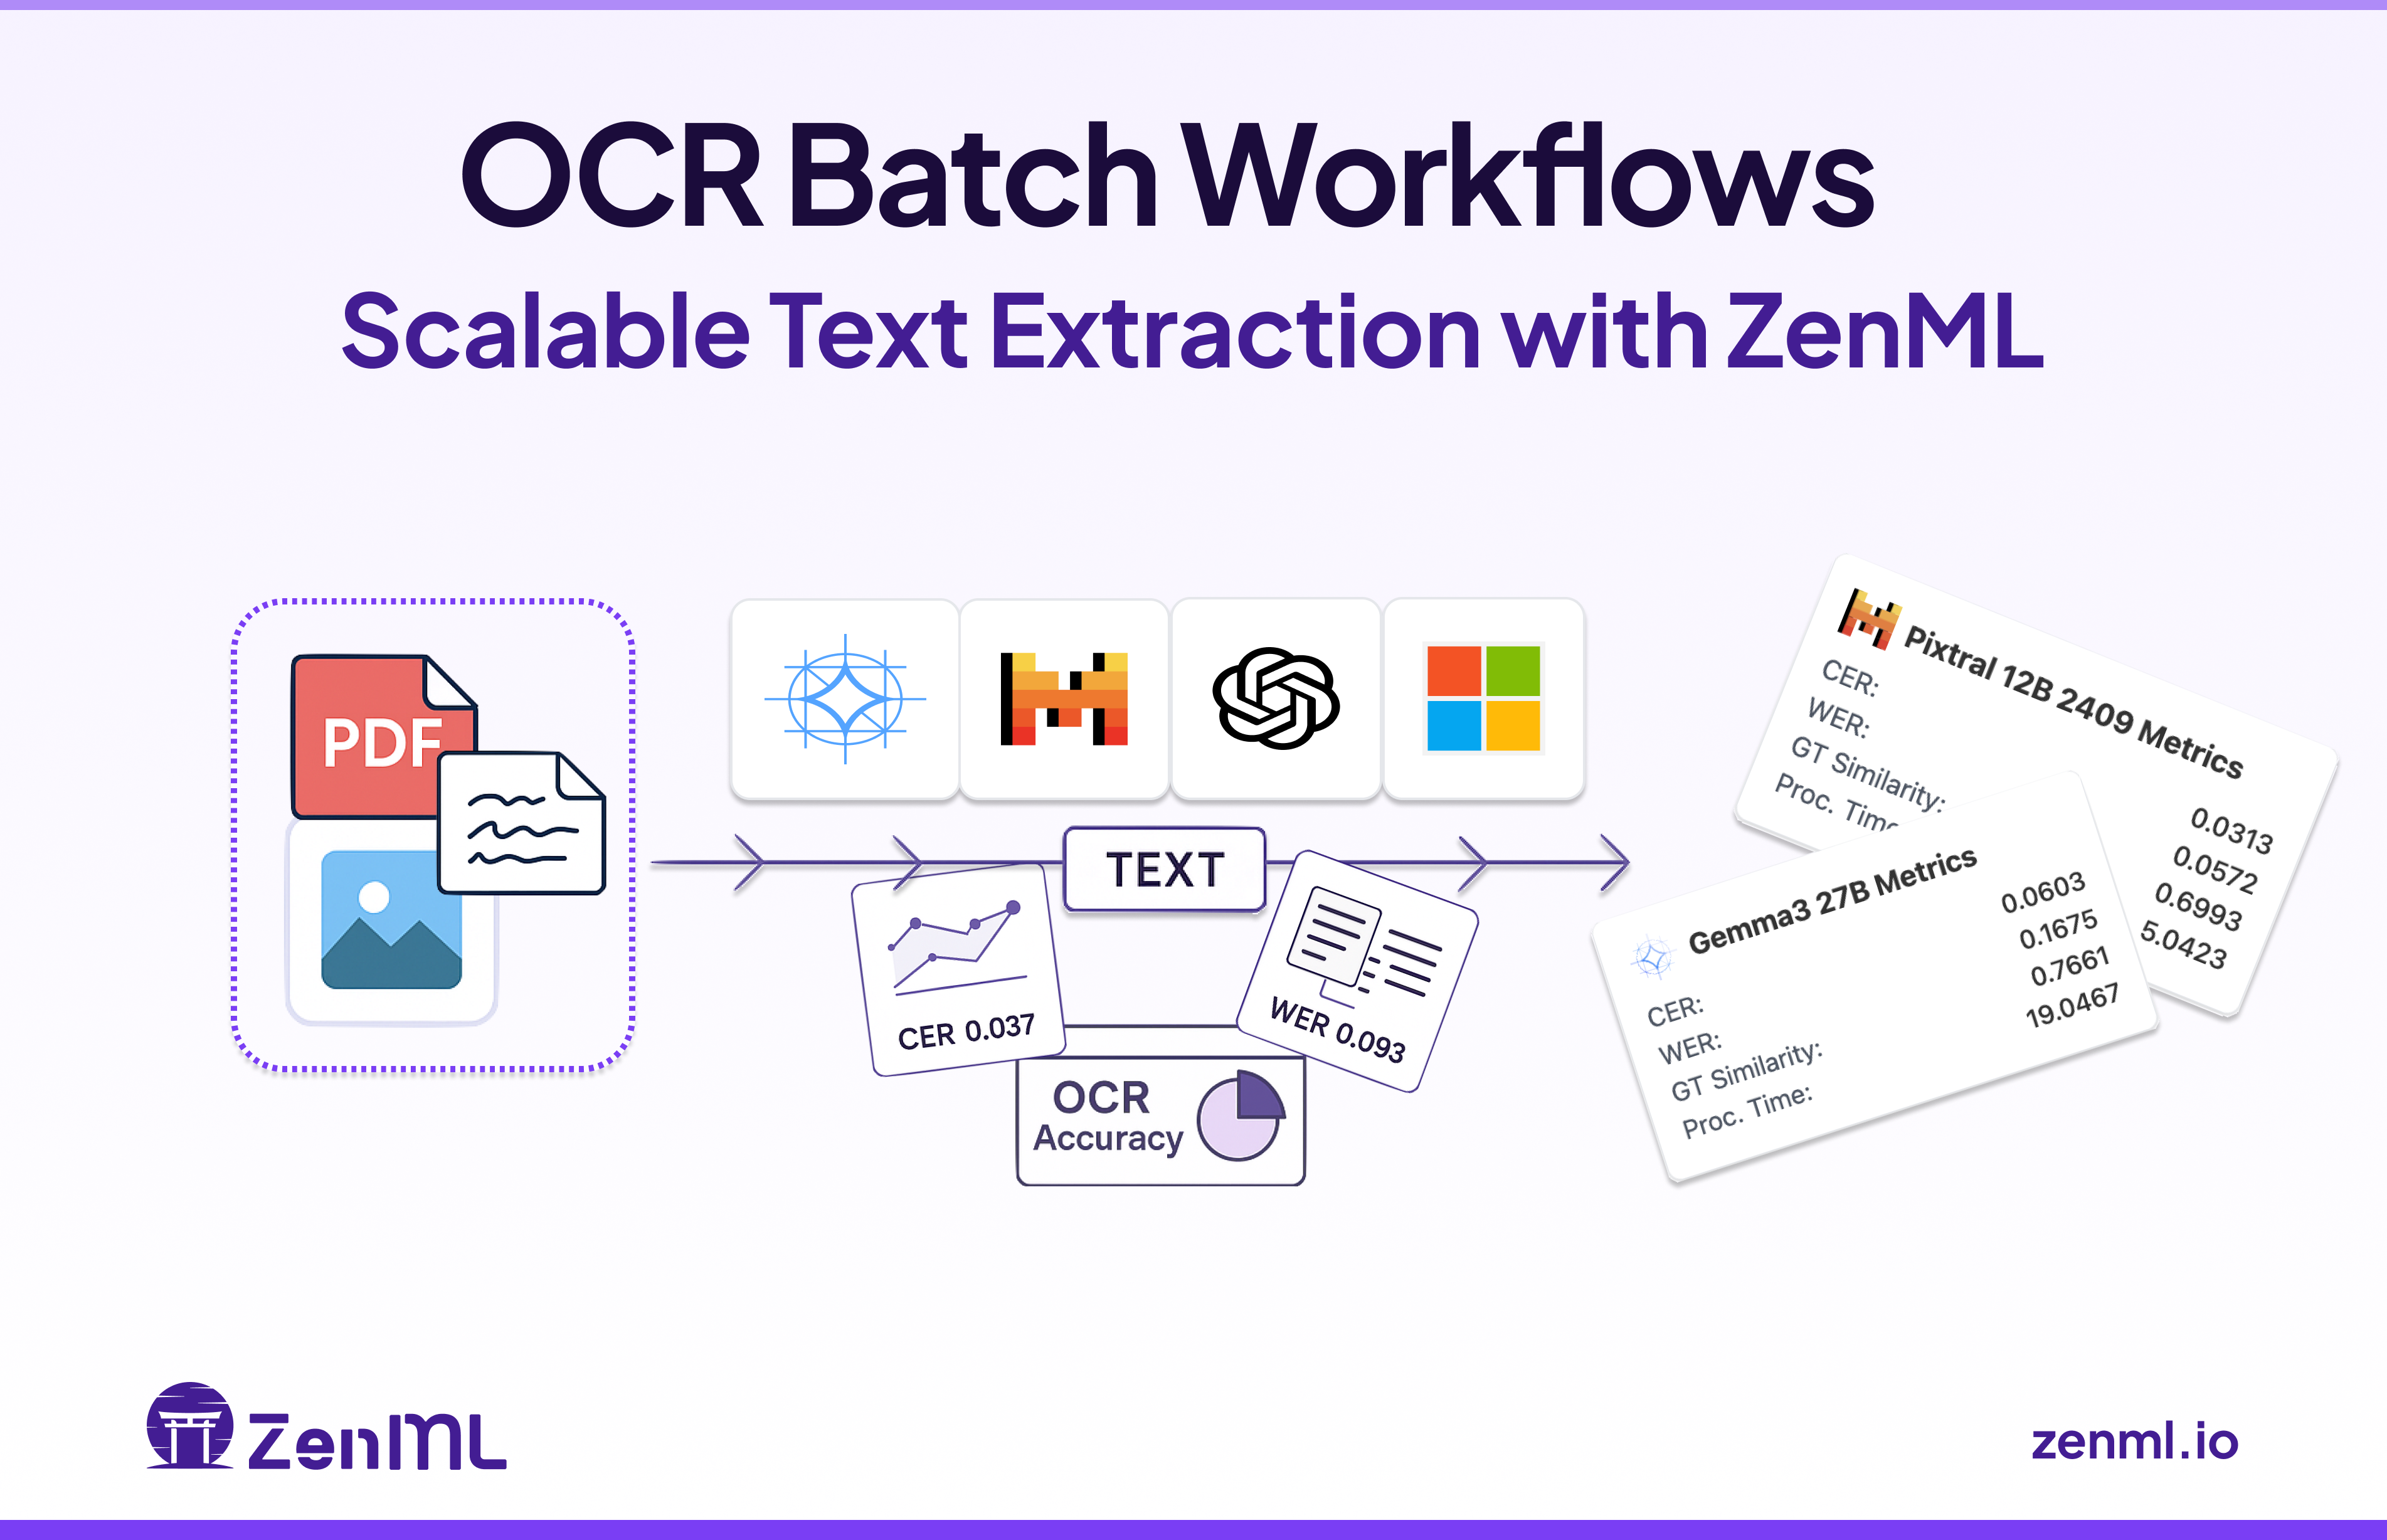
OmniReader is a flexible, scalable multi-model OCR workflow that orchestrates document processing pipelines, integrates various vision-language models, and tracks performance metrics to ensure reliable text extraction at scale.
What It Does
This framework provides a production-ready solution for batch OCR processing, enabling enterprises to process large volumes of unstructured documents efficiently and reliably. It supports multiple vision-language models, automatic performance evaluation, and detailed metrics tracking for model comparison.
How It Works
- Processes batches of documents using a unified interface for multiple OCR models
- Supports cloud-based APIs (OpenAI) and locally hosted models (Ollama)
- Evaluates model performance using metrics like Character Error Rate (CER), Word Error Rate (WER), and Levenshtein similarity
- Generates comparative visualizations and detailed performance reports
- Leverages ZenML for workflow orchestration, artifact tracking, and reproducibility
- Includes an interactive Streamlit app for side-by-side model comparison and prompt experimentation
Gallery